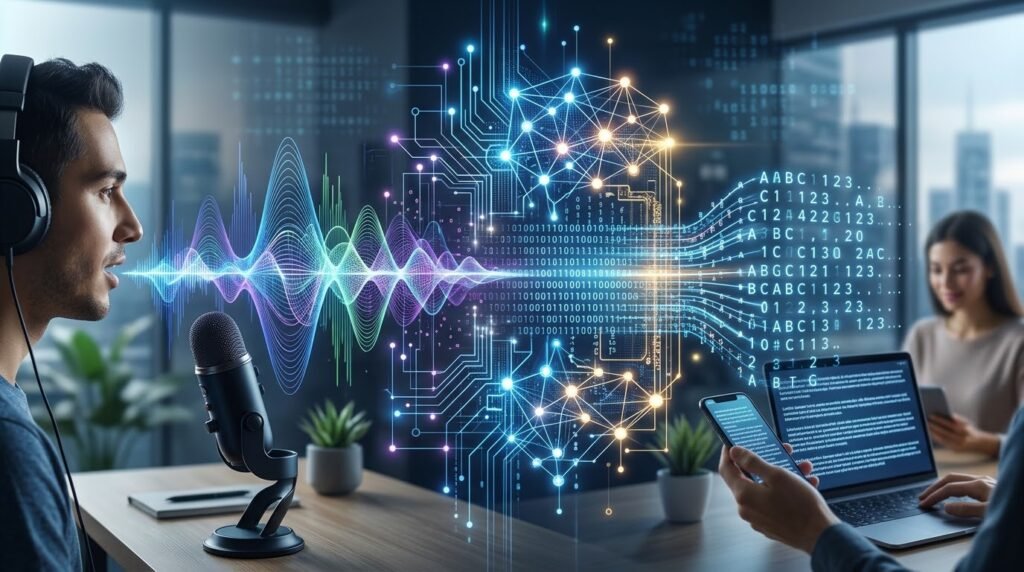
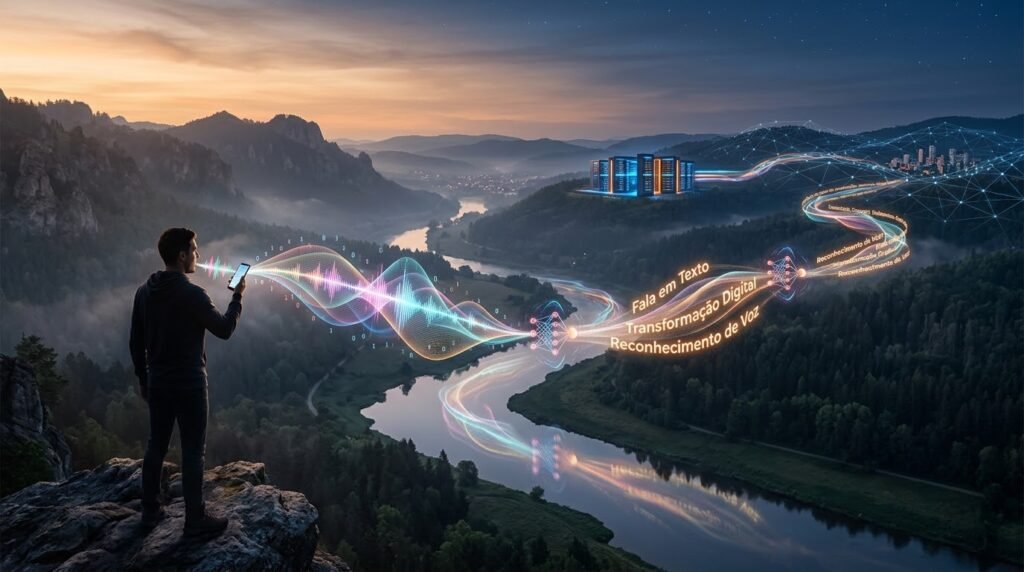
Você fala uma frase no celular e, quase instantaneamente, ela aparece escrita na tela. Pode parecer uma tarefa simples, mas por trás de uma transcrição de voz existe uma combinação de processamento de áudio, inteligência artificial e reconhecimento de padrões.
Essa tecnologia está presente em vários lugares do nosso dia a dia: assistentes virtuais, aplicativos de mensagens, ferramentas de acessibilidade, reuniões online e até sistemas usados para criar legendas automaticamente.
Mas como uma máquina consegue ouvir uma pessoa falando e descobrir quais palavras foram pronunciadas?
Primeiro, a voz precisa virar dados
Quando falamos produzimos ondas sonoras que se propagam pelo ar. Um microfone capta essas variações de pressão e as transforma em um sinal elétrico que pode ser convertido em dados digitais.
É nesse ponto que o computador começa a trabalhar, para uma máquina nossa voz não chega como palavras. Ela chega como uma sequência enorme de informações sobre frequência, intensidade e variações do som ao longo do tempo.
O primeiro desafio, portanto, é transformar esse sinal em algo que os sistemas de inteligência artificial consigam analisar.
A inteligência artificial procura padrões
Depois de receber o áudio o sistema analisa suas características e tenta identificar padrões associados aos sons da fala. O problema é que pessoas não pronunciam as palavras exatamente da mesma maneira.
A mesma frase pode ser dita por alguém com voz grave ou aguda, falando devagar ou rapidamente, com sotaque, em um ambiente silencioso ou com bastante ruído ao redor.
Mesmo assim, determinadas características acústicas aparecem com frequência suficiente para que modelos de inteligência artificial aprendam a reconhecê-las.
Para isso, esses modelos são treinados com grandes quantidades de exemplos de fala associados às respectivas transcrições. Com o treinamento o sistema aprende relações entre determinados padrões sonoros e as palavras que costumam representá-los.
Não é simplesmente “ouvir” cada palavra
Aqui está uma parte interessante. Um sistema moderno de reconhecimento de fala não precisa necessariamente identificar cada palavra de maneira isolada como se estivesse consultando um enorme dicionário. Ele também considera o contexto.
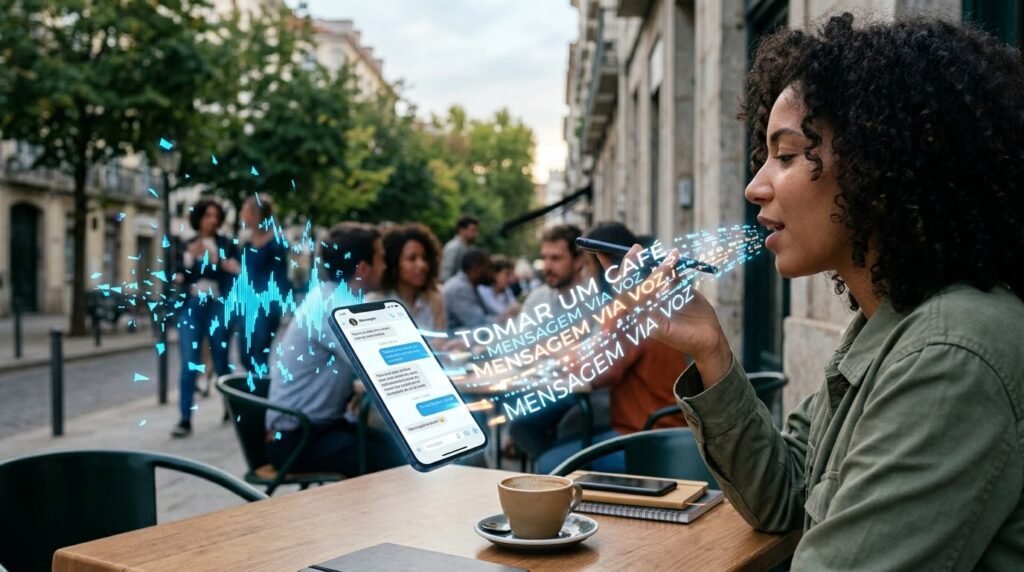
Imagine que alguém diga: “Eu vou tomar um café.”
O sistema precisa determinar quais palavras fazem sentido juntas, isso ajuda a diferenciar sons semelhantes e corrigir interpretações que, isoladamente, poderiam parecer possíveis.
Em outras palavras, o sistema não analisa apenas o que foi falado, mas também o que provavelmente deveria estar sendo dito naquele contexto.
E se a pessoa falar rápido?
É justamente aí que a tecnologia fica mais interessante. Na fala natural nós juntamos palavras, engolimos alguns sons, fazemos pausas inesperadas e mudamos a entonação. Muitas vezes, sequer percebemos isso.
Um sistema de transcrição precisa lidar com essas variações sem exigir que a pessoa fale como se estivesse lendo um texto palavra por palavra. Modelos modernos conseguem analisar o áudio em sequência e relacionar diferentes partes da fala para chegar a uma interpretação mais provável.
Por isso, a transcrição automática consegue funcionar mesmo quando a fala está longe de ser perfeitamente clara.
O sistema também precisa lidar com ruídos
Uma conversa não acontece necessariamente dentro de um estúdio. Pode haver trânsito, televisão ligada, pessoas conversando ao fundo, vento ou simplesmente o barulho do ambiente.
Antes mesmo de tentar descobrir o que foi falado, sistemas de processamento de áudio podem trabalhar para separar ou reduzir parte desses sons indesejados.
Isso não significa que o reconhecimento será perfeito. Quanto pior a qualidade do áudio, maior pode ser a dificuldade para identificar corretamente a fala.
E os sotaques?
Sotaques são outro desafio. Uma palavra pode apresentar diferenças significativas de pronúncia dependendo da região, do idioma ou da pessoa que está falando.
Os sistemas de reconhecimento de voz são treinados com diferentes exemplos justamente para aprender que uma mesma palavra pode soar de maneiras diferentes.
Quanto mais variadas forem as vozes e situações presentes nos dados de treinamento, maior tende a ser a capacidade do sistema de lidar com diferentes formas de falar.
Ainda assim, sotaques menos representados nos dados, palavras muito incomuns ou determinadas condições de gravação podem aumentar a quantidade de erros.
Onde entra a inteligência artificial?
A inteligência artificial é importante porque permite que o sistema aprenda essas relações a partir de exemplos. Em vez de programar manualmente uma regra para cada maneira possível de pronunciar uma palavra, os modelos aprendem padrões estatísticos presentes nos dados utilizados durante o treinamento.
Alguns sistemas também conseguem usar informações sobre o contexto para produzir uma transcrição mais coerente. É por isso que uma tecnologia que parece simplesmente “escutar e escrever” envolve várias etapas acontecendo em uma fração de segundo.
Da fala ao texto em poucos instantes
De maneira simplificada, o processo pode ser imaginado assim:
voz → microfone → sinal digital → análise do áudio → reconhecimento de padrões → interpretação do contexto → texto
Tudo isso acontece rapidamente porque os computadores conseguem realizar enormes quantidades de operações em pouco tempo e a tecnologia continua evoluindo.
Modelos mais recentes conseguem lidar melhor com diferentes idiomas, sotaques, ruídos e até situações em que várias pessoas estão falando.
Onde essa tecnologia é usada?
O reconhecimento automático de fala já deixou de ser uma curiosidade tecnológica.
Ele pode ser encontrado em:
– Transcrição de reuniões e entrevista: transforma conversas gravadas em documentos pesquisáveis.
– Legendas automáticas: converte diálogos em texto para acompanhar vídeos.
– Assistentes virtuais: interpreta comandos falados e tenta executar determinadas tarefas.
– Aplicativos de mensagens: permite ditar uma mensagem sem precisar digitá-la.
– Acessibilidade: pode ajudar pessoas que têm dificuldades para utilizar interfaces baseadas em teclado.
– Atendimento ao cliente: sistemas automatizados podem interpretar o que uma pessoa diz durante uma ligação.
– Ferramentas profissionais: médicos, jornalistas, pesquisadores e outros profissionais podem utilizar transcrição automática para transformar gravações em texto.
Por que ainda acontecem erros?
Apesar dos avanços, reconhecimento de voz não significa transcrição perfeita.
Uma palavra pouco comum pode ser interpretada como outra mais frequente. Ruídos podem confundir o sistema. Uma frase ambígua pode gerar uma interpretação diferente da intenção original.
Há também um detalhe curioso: nomes próprios costumam ser especialmente problemáticos. Se você disser o nome de uma pessoa, de uma empresa ou de um lugar que o sistema não conhece bem, ele pode tentar substituir aquele som por uma palavra mais comum.
É por isso que algumas transcrições automáticas conseguem escrever uma frase inteira corretamente e, de repente, inventam uma palavra completamente inesperada.
A máquina realmente entende o que estamos dizendo?
Essa é uma distinção importante. Reconhecer a fala e compreender profundamente uma conversa são tarefas diferentes.
O sistema de reconhecimento de voz transforma sons em palavras. Outras tecnologias podem então analisar essas palavras, identificar intenções, responder perguntas ou realizar tarefas. Ou seja, transformar voz em texto é apenas uma das etapas de uma interação entre humanos e máquinas.
Quando você conversa com um assistente de inteligência artificial por voz, por exemplo, podem existir várias etapas entre o momento em que você fala e o momento em que recebe uma resposta.
De ondas sonoras a palavras
A próxima vez que você ditar uma mensagem e ela aparecer quase instantaneamente na tela, vale lembrar do caminho que aconteceu nos bastidores. O celular não está simplesmente “ouvindo” como uma pessoa.
Ele está captando ondas sonoras, convertendo-as em dados, analisando padrões, comparando possibilidades e utilizando modelos treinados para determinar quais palavras provavelmente correspondem àquilo que foi dito.
Tudo isso acontece rápido o suficiente para parecer quase mágico, mas, por trás daquela frase que aparece na tela existe uma pequena fábrica digital trabalhando em silêncio.
📚 Produtos recomendados

Echo Spot com Alexa (Geração mais recente)
Echo Spot com Alexa (Geração mais recente) | Despertador inteligente com som vibrante | Cor Preta, com Acesso Antecipado à Alexa+
Ver na Amazon
Kindle Paperwhite 16 GB (Geração mais recente)
O Kindle mais rápido já lançado, com nova tela antirreflexo de 7” e bateria que dura semanas - Cor Preta
Ver na Amazon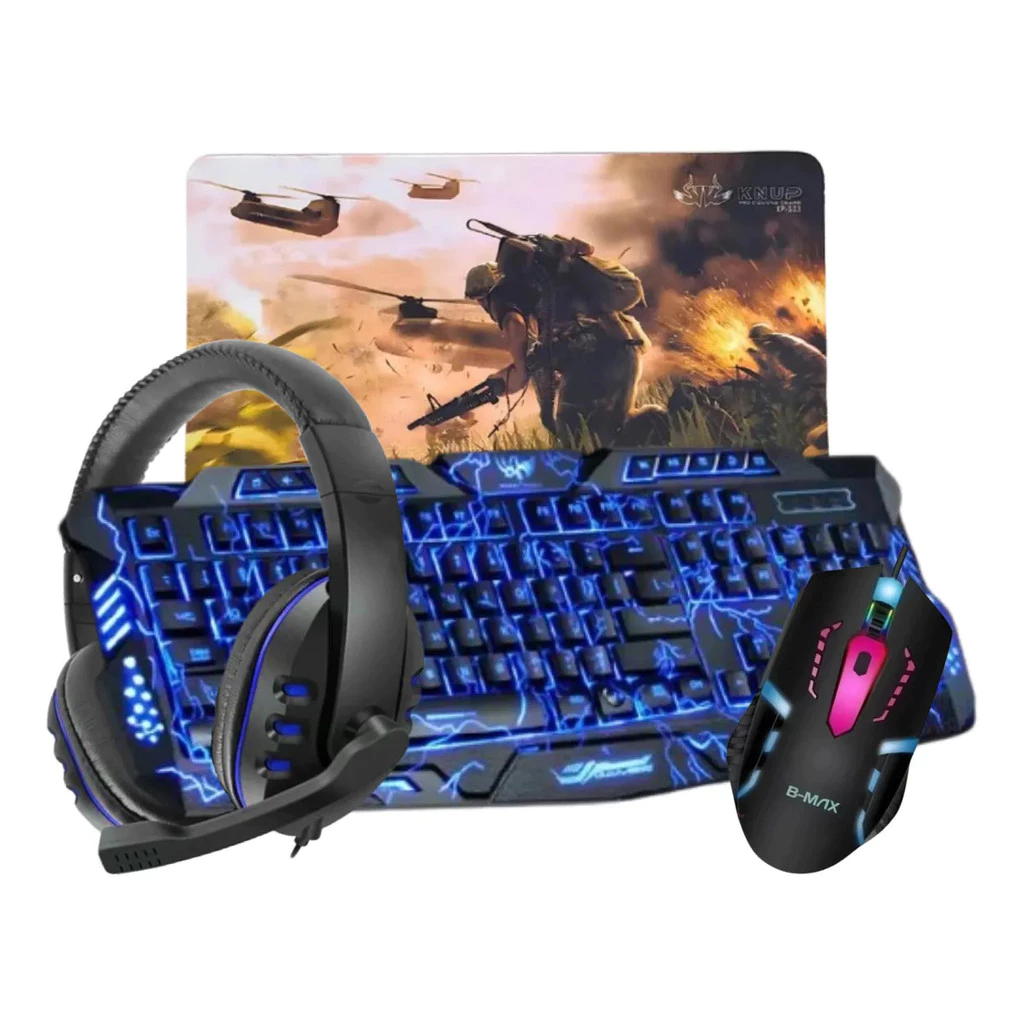
Kit Teclado Gamer M200 + Headset Gamer + Mouse Rgb 3200+ Mouse Pad Gamer
Experimente a imersão total no mundo dos games com o Kit Gamer Teclado Raios + Mouse RGB + Mouse Pad + Headset. Este conjunto foi projetado para oferecer desempenho e conforto, permitindo que você jogue por horas sem interrupções.
Ver na Shopee